Aanpak
Een roman schrijven met AI
Het recente nieuws over de AI-race en het debat over risico’s en regulering vormden de inspiratie voor een filmscript. Ik begon met het verkennen van verschillende storylines en concepten. Daar zijn nog een paar ideeën van over die ik misschien later gebruik.
Ik verkende wat er nodig zou zijn om er een film van te maken. De uitvoering van een film zou veel tijd kosten, dus dacht ik eerst aan een short, maar ook daarvoor bleek ik flink wat tools nodig te hebben waar ik me op zou moeten abonneren. Dus besloot ik te beginnen met een roman, want dat kon ik met de tools die ik al had: een AI-abonnement. Verfilmen of een short maken kan altijd nog. Ik liet eerst een concept schrijven, wat uitkwam op ongeveer 20.000 woorden. Dat heb ik gelezen en daar heb ik nog wat wijzigingen op aangebracht.
Ik liet er een pdf van genereren, en omdat ik het ging lezen, heb ik gewerkt aan de leesbaarheid: de lettergrootte en de uitlijning.
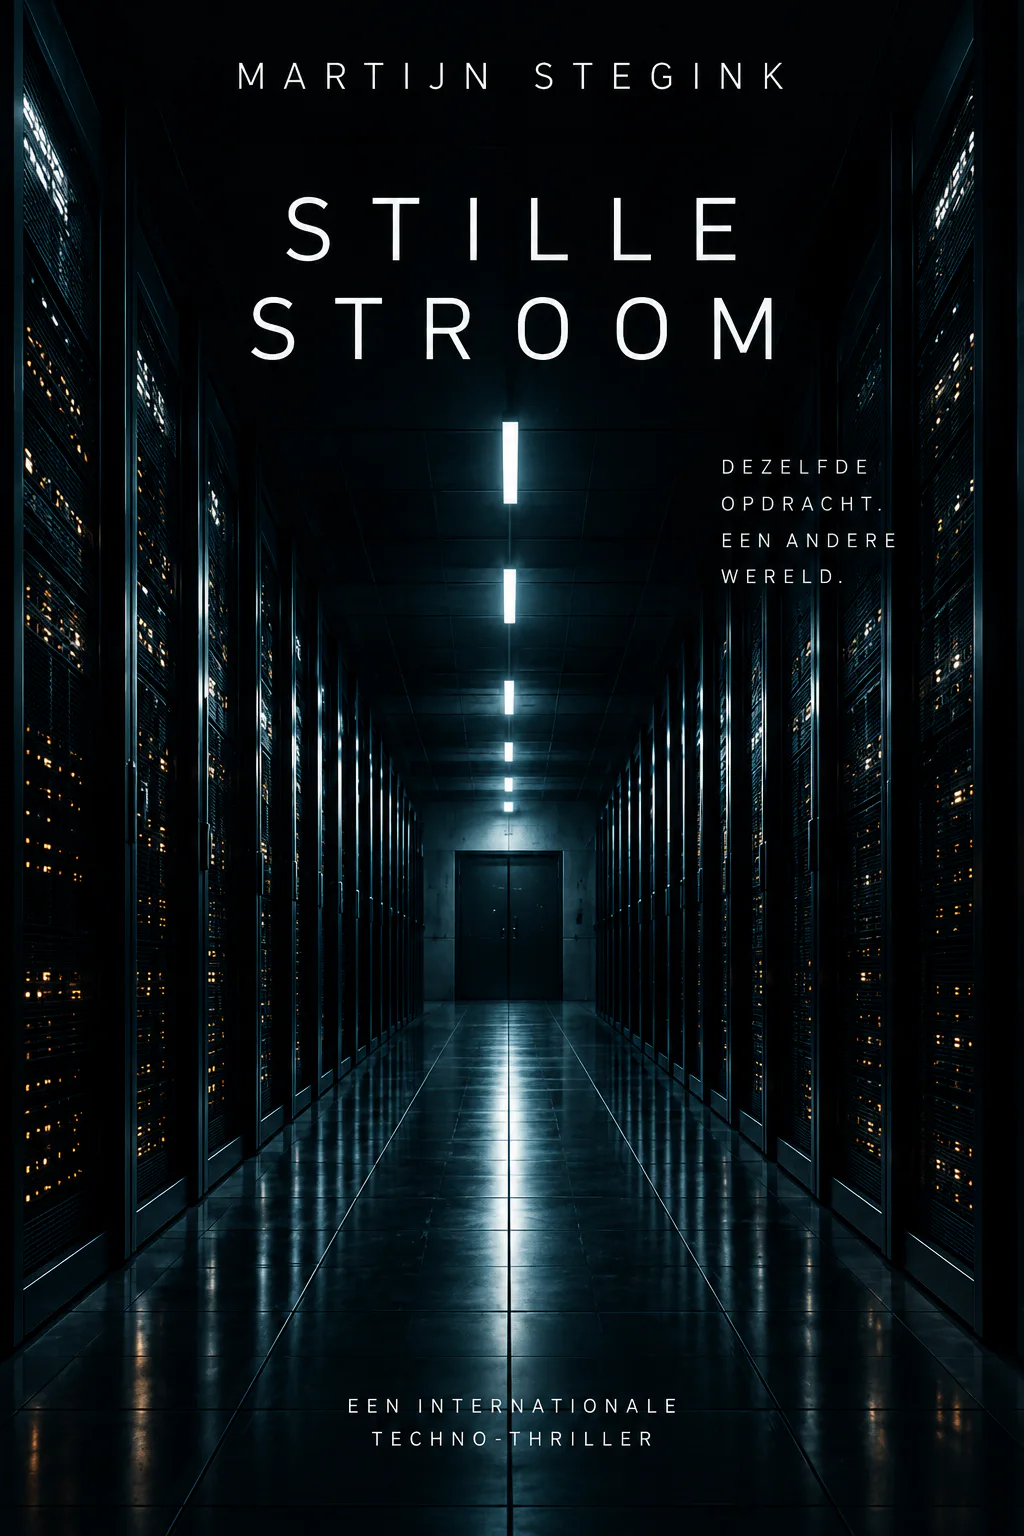
Mijn vrouw is creatief en bood aan een cover te maken. Ik stuurde haar een samenvatting van het boek, en zij kwam terug met een aantal concepten waaruit ik er één heb gekozen. Dit is het resultaat.
Voor de verdere uitwerking heb ik eerst een stijlprofiel laten vastleggen: lange, aftastende zinnen met interioriteit, meervoudig perspectief dicht op de personages maar niet in de ik-vorm, spaarzame dialoog, weinig actie-tempo, meer aandacht voor de menselijke en maatschappelijke tol van een gebeurtenis dan voor achtervolgingen. Dat is een andere stijl dan hoe ik zelf communiceer, op mijn werk en privé, maar toegespitst op wat bij een roman past.
Voordat ik opdracht gaf om het boek verder uit te werken, ging ik na hoeveel woorden een roman normaal gesproken heeft: 65.000 tot 75.000 woorden. Daarop gaf ik de opdracht om het boek verder uit te werken. Het bleek nodig om de consistentie en de verhaallijnen te bewaken: de extra content moest in meerdere kleine rondes worden toegevoegd in plaats van in één grote slag.
Elke ronde bleek bewust maar twee nieuwe alinea’s per hoofdstuk toe te voegen, zo’n 2.500 tot 3.500 woorden per ronde in totaal over 25 hoofdstukken. Dat is geen technische beperking, maar een kwaliteitskeuze: bij elke ronde moet precies worden bijgehouden welk soort toevoeging, dialoog, interioriteit, sensorische details, flashbacks, al in eerdere rondes per hoofdstuk is gebruikt, om herhaling te voorkomen. Hoe meer er in één ronde in één hoofdstuk wordt gestopt, hoe groter het risico dat het verhaal te vol raakt, het tempo verzwakt, of dat het zichzelf binnen die ronde gaat herhalen.
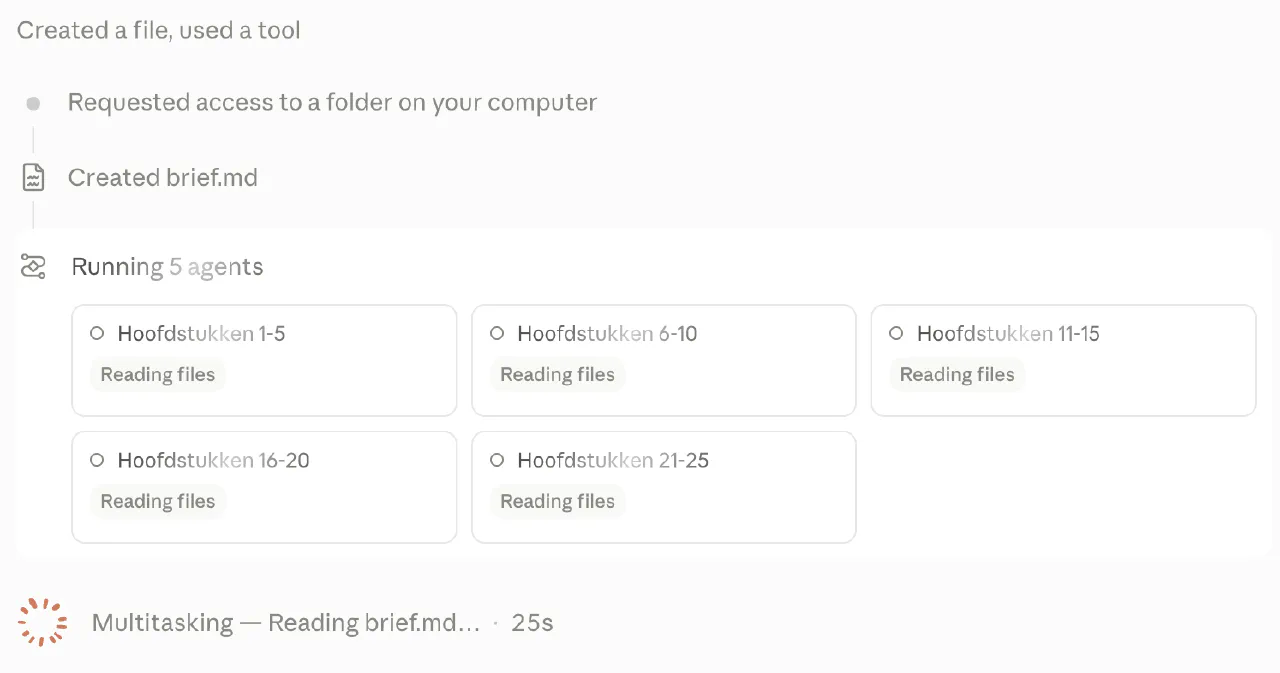
Ik zag dat ik hard door mijn tokens ging omdat elke ronde de hele tekst opnieuw gelezen en verwerkt moest worden. Daarom besloot ik het boek te splitsen in een bestand per hoofdstuk, om het tokenverbruik te verminderen: zo hoefde bij elke ronde alleen het relevante hoofdstuk gelezen te worden in plaats van het hele boek. Als bijkomend voordeel konden er zo ook meerdere subagents tegelijk aan de verbetering werken.
Het boek heb ik verder afgebouwd met de overige onderdelen: titelpagina, inhoudsopgave, sectiepagina’s per deel, en een colofon met copyright.
Tenslotte de tekst over de auteur. Die heeft een paar rondes gekost, omdat mijn eigen instructies aan de AI een paar keer de verkeerde kant op stuurden: de ene keer te licht voor een thriller, de andere keer te pretentieus of te filosofisch. Uiteindelijk heb ik die tekst zelf geschreven, en heeft AI hem nog wat aangescherpt. Zodra ik daar helemaal tevreden over was, heb ik naast de pdf ook een epub gemaakt. Dat is nodig om het boek op alle apparaten goed leesbaar te maken, met een lettergrootte die meegaat met wat de lezer zelf instelt.
Na 6 rondes stond de teller op 32.177 woorden, na 14 rondes op 70.582 woorden, precies in het midden van de 65.000-75.000 woorden die ik voor ogen had. Drie delen, 25 hoofdstukken, één nawoord. Vijftien pdf-versies voordat ik er een definitief noemde, drie epub-versies daarna.
Wat er misging: ik verwachtte dat het boek na het eerste concept min of meer vanzelf verder zou worden afgeschreven. Na de eerste ronde gaf ik nog een paar keer opdracht om een ronde te doen, en tot mijn verbazing kwam er steeds maar heel weinig bij. Uiteindelijk stelde ik de vraag waarom dat zo ging, en realiseerde ik me hoe hard ik door mijn tokens heen ging, en besloot ik tot de splitsing in aparte hoofdstukbestanden. Had ik die vraag eerder gesteld, dan had ik mezelf een paar rondes zoeken bespaard.
Daarnaast een paar kleinere dingetjes. De uitlijning stond niet meteen goed. Op een gegeven moment ontbraken de sectiebladen. Een sectienummer stond boven de titel in plaats van erbij. En de inspiratie voor het boek kwam op meerdere plekken terug, in iets andere bewoordingen, en klopte op één plek niet meer helemaal met de werkelijkheid. Ook de tekst over de auteur kostte meer omwegen dan nodig, tot ik hem gewoon zelf schreef; dat had ik net zo goed meteen kunnen doen.
Gebaseerd op mijn eigen aanpakdocument bij Stille Stroom, versie 4.